Siamo ESIGON. Il nuovo brand di ESG Services. Scopri il nostro percorso
ESG Services - Rettangolo sfondo
Cloud Monitoring Incident Management

Cloud monitoring: troppi alert, poca chiarezza.

2 novembre 2026

ESG Services - Cloud monitoring: troppi alert, poca chiarezza.

Cloud monitoring: come rendere efficace il monitoraggio

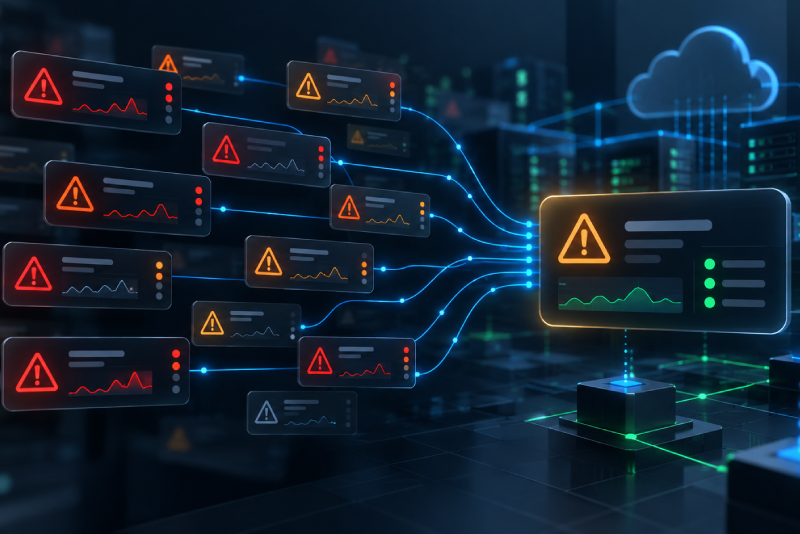
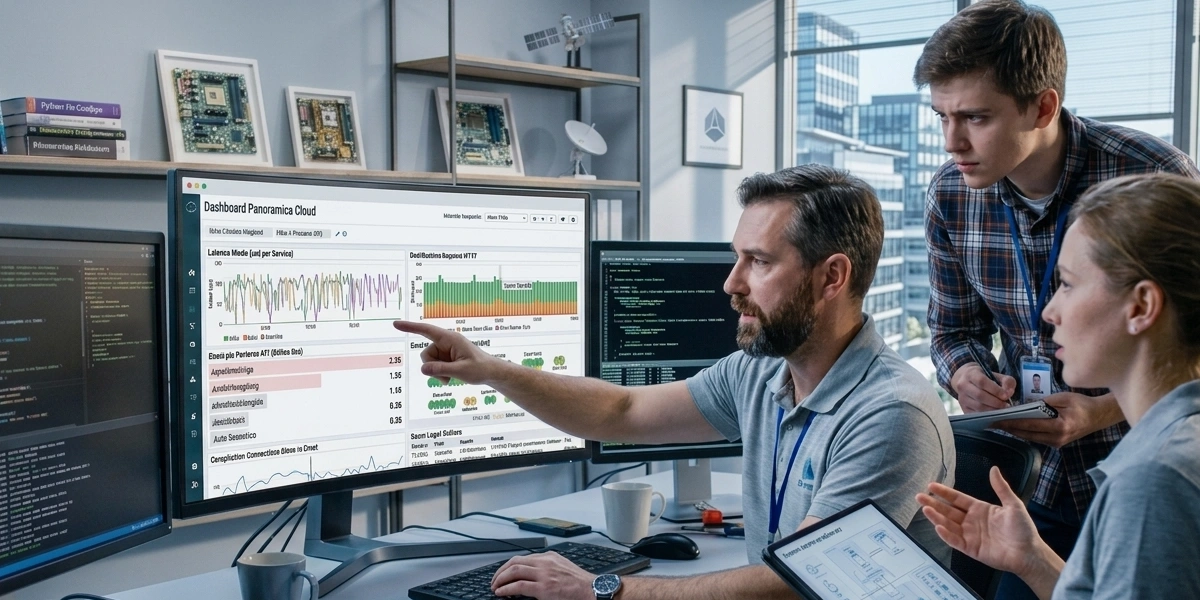
Un’applicazione rallenta. Arrivano notifiche sui tempi di risposta, sugli errori e sulle connessioni al database. Il team IT vede numerosi allarmi, ma deve ancora capire se sta affrontando problemi distinti oppure gli effetti di un unico incidente.

È in situazioni come questa che si misura l’efficacia del Cloud Monitoring: le informazioni raccolte devono aiutare a riconoscere l’impatto sui servizi e a scegliere dove intervenire.

Per l’IT Manager, migliorare il monitoraggio significa quindi lavorare sulla qualità degli alert: quando si attivano, quali informazioni contengono, chi li riceve e quale azione richiedono.
È il punto di collegamento tra rilevazione tecnica e incident management, il processo che coordina la risposta agli incidenti e il ripristino del servizio.

Perché il cloud monitoring genera alert ripetitivi o poco utili

La moltiplicazione delle notifiche può dipendere da regole costruite nel tempo senza una revisione complessiva: controlli duplicati, soglie applicate indistintamente a sistemi diversi, segnalazioni ancora attive su risorse che hanno cambiato funzione.

Occorre però distinguere tre situazioni:

  • Falso positivo: la segnalazione indica una criticità che, alla verifica, non sussiste.
  • Alert corretto ma poco rilevante: la condizione viene rilevata correttamente, ma non richiede l’intervento previsto dalla notifica.
  • Alert ridondante: aggiunge poche informazioni rispetto a un problema già segnalato.

La distinzione orienta la correzione.
Un falso positivo richiede di rivedere la regola o la qualità dei dati.
Una condizione non urgente può diventare un’attività pianificata.
Le segnalazioni ridondanti possono essere raggruppate.

L’accumulo di notifiche poco utili può alimentare l’alert fatigue, il sovraccarico che rende difficile mantenere l’attenzione sugli allarmi importanti. Le linee guida raccomandano di riservare le notifiche che interrompono il lavoro a condizioni che richiedono un’azione, evitando di trattare ogni variazione tecnica come un’emergenza.

Calibrare le soglie sul comportamento dei sistemi

Una soglia ha senso nel contesto del sistema osservato. Un aumento dell’utilizzo del processore durante un’elaborazione programmata può essere atteso; lo stesso andamento su un servizio interattivo può richiedere un approfondimento.

Il primo riferimento è la baseline, cioè il comportamento abituale del sistema nelle diverse condizioni di utilizzo. Serve a interpretare le variazioni rispetto a carichi, orari e cicli operativi.
La baseline, tuttavia, descrive ciò che accade normalmente: non stabilisce automaticamente ciò che è accettabile per l’azienda. Un’applicazione abitualmente lenta può comunque non soddisfare le esigenze degli utenti.

Per rivedere una regola di alerting occorre considerare:

  • il valore oltre il quale la condizione diventa rilevante;
  • la durata o la frequenza del superamento;
  • i criteri di rientro dall’allarme;
  • il comportamento previsto quando mancano dati.

La documentazione di Amazon CloudWatch mostra, per esempio, come la valutazione possa considerare più rilevazioni e come la gestione dei dati mancanti debba dipendere dal significato della metrica. L’assenza di misure non equivale necessariamente al corretto funzionamento del sistema.

Per metriche con variazioni ricorrenti, la rilevazione delle anomalie può integrare le soglie statiche. Amazon CloudWatch permette di confrontare i valori osservati con una fascia attesa che tiene conto anche di andamenti orari, giornalieri e settimanali. Uno scostamento resta però un segnale da interpretare, non la prova automatica di un incidente.

Allungare indiscriminatamente i tempi di valutazione per ridurre le notifiche può ritardare il riconoscimento dei guasti: la taratura deve mantenere la rapidità necessaria per ciascun servizio.

Assegnare le priorità in base all’impatto sui servizi

La gravità di una notifica dovrebbe riflettere il servizio coinvolto, l’estensione del problema e l’urgenza dell’intervento.

Un picco di consumo su una risorsa non descrive, da solo, l’esperienza degli utenti. Per stabilire le priorità sono utili anche indicatori come errori, tempi di risposta e riuscita delle operazioni importanti. Le pratiche suggeriscono di basare l’allarme sui sintomi rilevanti per il servizio, mantenendo i dettagli interni a supporto della diagnosi.

Una possibile classificazione operativa è la seguente:

SituazioneGestione prevista
Operazione aziendale critica non disponibileAttivazione immediata del presidio competente
Degrado che rischia di compromettere il servizio
prima del prossimo intervento ordinario
Valutazione urgente e possibile escalation
Problema stabile, con margine per intervenireTicket con responsabile e scadenza
Informazione utile per analisi e pianificazioneDashboard o report


Questa classificazione va adattata alle dipendenze dell’organizzazione.
Un processo notturno, per esempio, può diventare urgente se il suo mancato completamento impedisce l’avvio delle attività del mattino.
Anche gli avvisi preventivi restano necessari: una risorsa prossima all’esaurimento può richiedere un intervento prima che gli utenti avvertano un disservizio. Il criterio è il rischio concreto e il tempo disponibile per gestirlo.

Correlare gli alert per ricostruire il problema

Consideriamo uno scenario ipotetico.
Un’elaborazione non prevista occupa a lungo risorse del database. Le richieste dell’applicazione rallentano, alcune superano il tempo massimo di attesa e aumentano gli errori.
I controlli su database, applicazione e transazioni utente generano numerose notifiche.

Aprire un’indagine separata per ogni allarme frammenterebbe il lavoro. Il team può invece ricostruire una sequenza comune, confrontando orari, servizi coinvolti e dipendenze.

Per organizzare le notifiche sono utili meccanismi distinti:

  • Deduplicazione: evita invii duplicati dello stesso alert.
  • Raggruppamento: raccoglie segnalazioni correlate in una notifica.
  • Inibizione: sospende determinate notifiche quando è attivo un altro allarme previsto dalla regola.
  • Silenziamento temporaneo: interrompe notifiche selezionate per un periodo definito, per esempio durante una manutenzione.

Queste funzioni vanno configurate con attenzione: raggruppare notifiche non significa dimostrare che abbiano la stessa causa, mentre un’inibizione troppo ampia può nascondere problemi indipendenti.

Nello scenario ipotetico, il database rappresenta una possibile origine del degrado.
La verifica richiede di esaminare le elaborazioni attive, i log e, se disponibili, le tracce delle richieste attraverso i componenti. La correlazione restringe il campo d’indagine; la diagnosi deve confermare il legame.

Collegare ogni alert operativo all’incident management

Una notifica diventa operativa quando chiarisce chi deve prenderla in carico e quale verifica avviare.
Per gli alert che richiedono un intervento, una scheda essenziale dovrebbe indicare:

  • servizio e ambiente coinvolti;
  • condizione rilevata e momento di inizio;
  • impatto osservato o rischio da verificare;
  • team responsabile e percorso di escalation;
  • collegamenti ai dati diagnostici;
  • procedura per le prime verifiche.

Questa procedura, spesso chiamata runbook, descrive controlli, possibili azioni e condizioni per coinvolgere altri specialisti. Deve aiutare a decidere, senza presupporre che ogni allarme abbia già una causa certa.

Quando il problema richiede il contributo di più team, l’Incident Management definisce il coordinamento degli interventi, la comunicazione e la registrazione delle attività. Il ripristino può richiedere una mitigazione prima che l’analisi delle cause sia conclusa. La preparazione delle procedure e la chiarezza delle responsabilità diventa quindi fondamentale.

Per verificare i miglioramenti, l’IT Manager può osservare il tempo di presa in carico, le notifiche ripetute per incidente, gli alert senza responsabile e i disservizi scoperti prima dagli utenti.
Questi indicatori vanno letti insieme: un calo delle notifiche, da solo, non dimostra una maggiore efficacia.

Da dove iniziare

Un punto di partenza concreto è riesaminare un incidente recente: quali alert hanno aiutato a riconoscerlo, quali hanno ripetuto informazioni e quali sono mancati?
Da questa ricostruzione si possono correggere soglie, destinatari e procedure, verificandoli poi con una prova controllata. 

La domanda da porre per ogni notifica è semplice: chi la riceve dispone delle informazioni necessarie per decidere cosa fare e con quale urgenza?

Quando arriva un alert, il tuo team sa come intervenire?

Ogni ritardo nella risposta può prolungare un disservizio e rallentare le attività aziendali. Ti aiutiamo a rendere più chiaro come e quando intervenire.

Parla con un esperto

Iscriviti alla nostra Newsletter

Potrebbe anche interessarti